
類似的概念在前面已經學過了。
當模型要預測類別時,會劃出一條臨界線;如果變數更多,這條線也可能變成臨界面或更高維度的超平面。資料落在邊界的一側,就會被分類為 A;落在另一側,則會被分類為 B。
**SVM **的核心概念,是找出一條能讓兩個類別之間距離最大的分類邊界,引用前輩的繪圖,SVM就是要找那兩條線組成的邊界。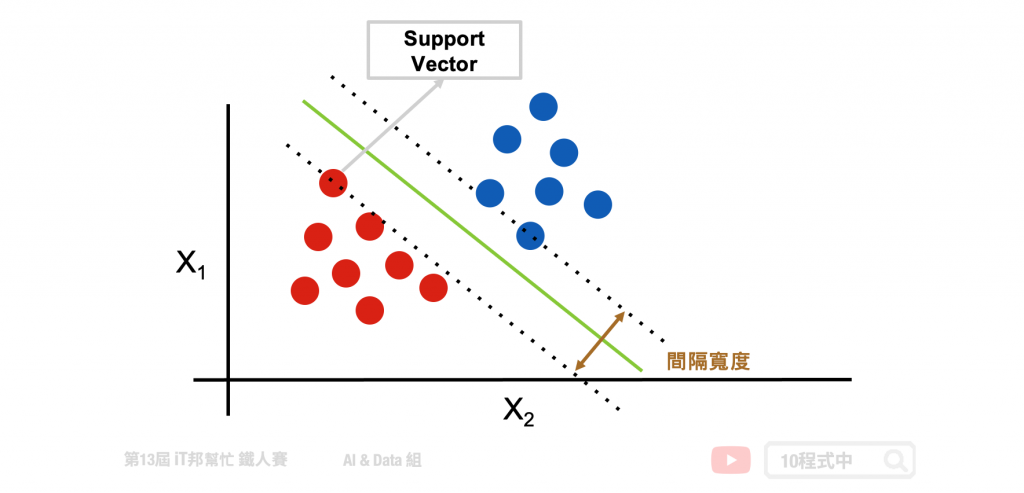
也就是說,那些已經很明顯屬於某一類、離邊界很遠的樣本,模型其實不太在意;真正重要的是靠近分類邊界、最容易被混淆的那些樣本。
為什麼這是一個特別的方法呢?我們可以用分類蘋果和橘子來理解。一般來說,我們可能會用常見的蘋果和常見的橘子圖片來擷取特徵,訓練模型判斷兩者的差異。但 SVM 更重視的是那些位在邊界附近的例子,例如「很像橘子的蘋果」和「很像蘋果的橘子」。透過這些最容易混淆的樣本,SVM 可以找到更穩定的分類邊界,進而判斷新的資料比較像蘋果,還是比較像橘子。
Kernel SVM
前面講到SVM會用極端例子來建立邊界,那萬一模型找不到一個明確邊界呢? SVM本身是假設資料是線性、且可分邊的,但如果資料不是這個特性時,我們首先要把資料做些處理,例如先mapping到另外一個dimension(比方說全部都變次方數),通常重新投影過後,資料的邊界就出來惹。而投影的方式,就是講者介紹的kernel trick,做完kernel trick後,我們就可以很清楚的看到資料的邊界了呢(引用這篇說明的圖)
當然不意外的,只要是mapping 肯定不只一種方法,而kernel也是如此,基本上老師用的都是預設rbf算式。要詳細研究的可以看這篇的推導,我作為初學者且沒啥數學理解能力是不打算特別去理解其中的細節,免得迷失在數學森林裏頭XD
實作的部分好像沒什麼特別的XD 只要找到正確的函式,作法差不多都那樣( 真的這麼簡單?? 這實在太好操作到我覺得很可疑ㄟ),
SVM 跟kernal SVM基本上是一樣的函式,所以就合併一起寫了~
SVM的官方說明給的代碼:
from sklearn import svc
X = [[0, 0], [1, 1]]
y = [0, 1]
clf = svm.SVC(kernel = 'linear') -- 宣告 svm函式
clf2 = svm.SVC(kernel = 'rbf') --宣告kernel svm函式
clf.fit(X, y) --帶入train_x,train_y 進行model 訓練
clf2.fit(X, y) --帶入train_x,train_y 進行model 訓練
而最後要看結果就是
clf.predict([[變數1,變數2 ]])
clf2.predict([[變數1,變數2 ]])
如果有做feature_scaling,也記得要在predict欄位內作轉置,後續評估的方式跟前述的logistics regression一樣,可以用混淆矩陣跟accuracy score看預測的準確度。
補充一個我今天忽然想到的問題,這麼複雜的模型到底是什麼情境需要使用?
查了一下研究,有蠻多醫療影像類類方面的使用,其他有看到垃圾郵件分類,不過我查了google的郵件分類做法,他們用的方法很複雜而且會學習你的分類模式作調整(好驚人!!),恩、所以說這個模式我應該是通常用不太到就是了。
reddit上有人這樣說:
就我個人經驗,SVM 這種模型在你不做超出目前資料範圍的推測(也就是說,未來的資料在目前觀察到的資料範圍內)而且結果的雜訊很低,以及相似的輸入 => 相似的結果時,效果最好。所以,當你有很多資料,而且資料對輸出的預測性很高時,可以考慮用 SVR。特別是當輸出是一個實數(不是 true/false)的時候。大家常常忘記,在深度學習出現之前,SVM 可是很厲害的——而且是有原因的。
另外有人回說:
當你需要快速完成事情時,它仍然是最先進的。在 SVM 上進行推論的速度快了好幾個數量級,而且在許多行業應用中,速度比使用神經網絡獲得的微小準確性提升更重要。每秒 10,000 個項目達到 95%,還是每秒 18 個項目達到 98%?

 duckravel48

 iThome鐵人賽
 看影片追技術